A tua IA não conhece o teu negócio. O RAG corrige isso
O RAG dá à IA acesso aos teus documentos antes de responder. Onde se aplica para lá do chatbot, como reduz custos e onde falha.
31 de outubro de 2026
Há muita gente a ensinar a ligar o n8n a um modelo de IA e a chamar a isso um assistente. Na demonstração funciona. Em produção, e isto é a minha experiência, é aqui que a maioria dos chatbots falha: o modelo responde com o que aprendeu na internet, não com o que o teu negócio sabe.
O chatbot é só a parte visível do problema. A causa está por baixo, e a solução serve para muito mais do que atendimento.
O problema não é o modelo
Um modelo de linguagem não conhece os teus preços atuais, os teus contratos, os procedimentos da tua equipa nem o histórico dos teus clientes. Isso nunca fez parte do que ele aprendeu.
E quando não sabe, não diz "não sei". Produz a resposta que soa mais provável. Daí saem três falhas que se repetem:
- Inventa. Um prazo de entrega, uma condição de garantia, uma funcionalidade que não existe, tudo dito com confiança.
- Está desatualizado. O que o modelo aprendeu tem data de corte. A tua tabela de preços mudou depois disso.
- Não vê o que é privado. Procedimentos internos, propostas antigas e contratos nunca estiveram ao seu alcance.
Uma resposta errada dita com confiança é pior do que nenhuma resposta.
O que é o RAG, em um minuto
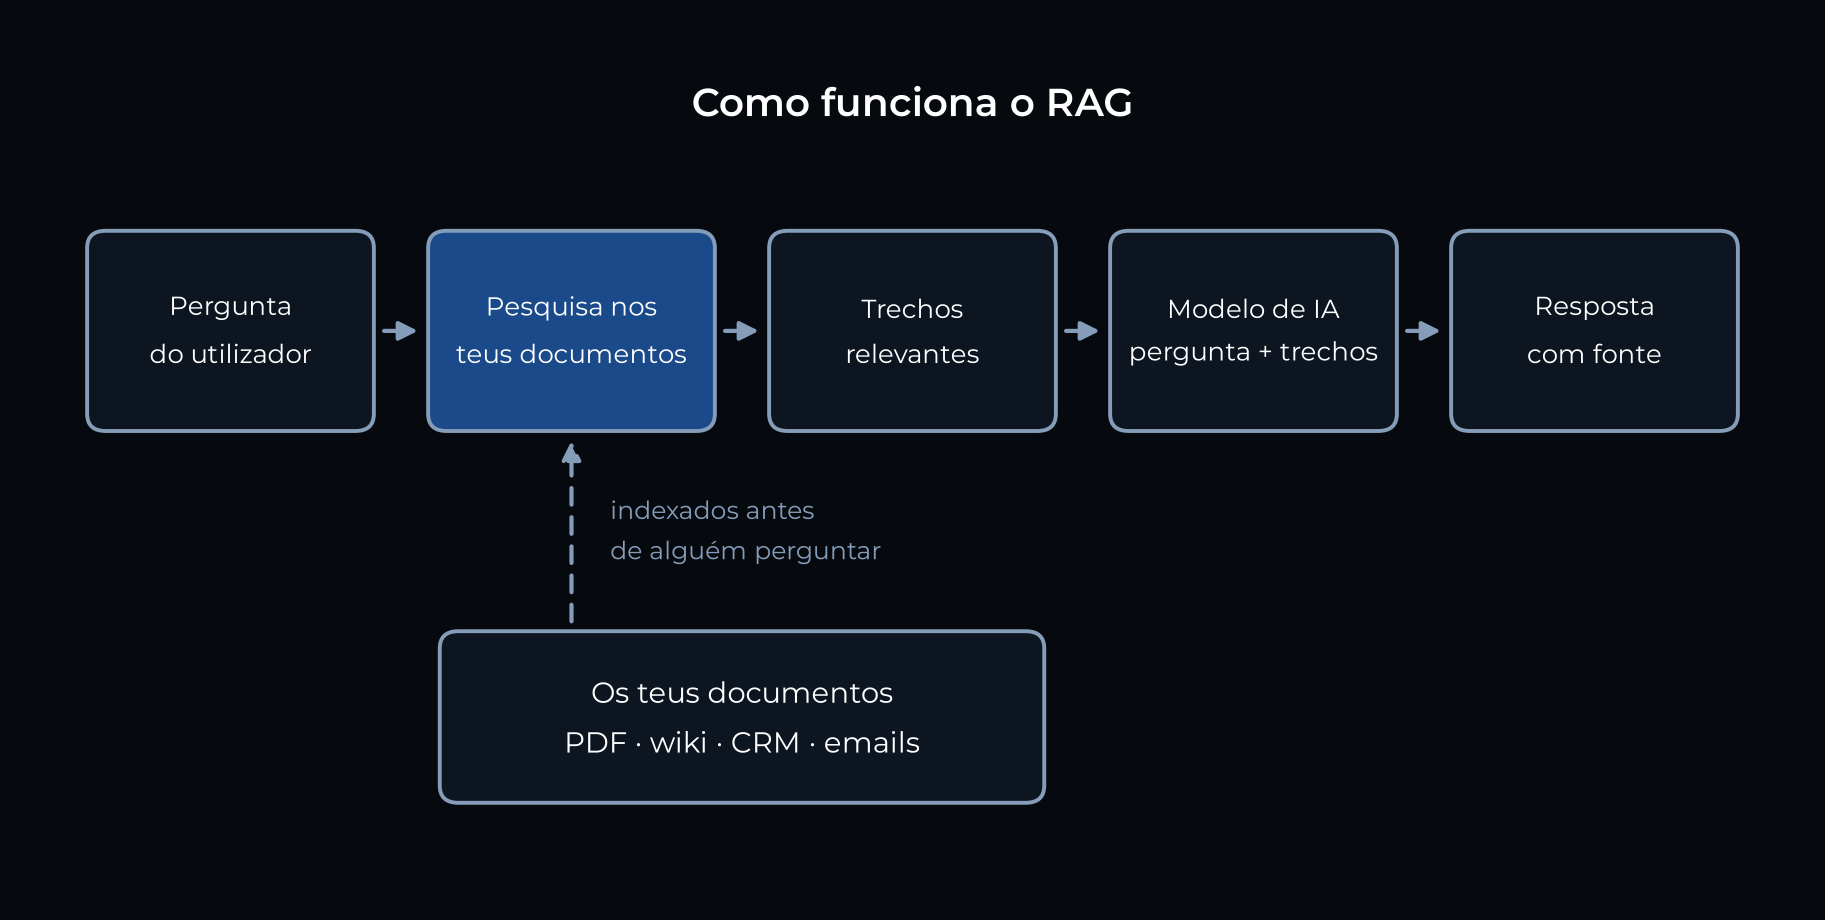
RAG quer dizer Retrieval-Augmented Generation: geração aumentada por pesquisa. A forma mais simples de o perceber é a diferença entre um exame de memória e um exame com consulta. Em vez de pedires ao modelo que responda de cabeça, entregas-lhe os documentos certos no momento da pergunta.
- Antes de tudo: os teus documentos são partidos em trechos e indexados, para se poder pesquisar por significado e não só por palavra exata.
- Alguém pergunta.
- O sistema pesquisa e encontra os trechos mais relevantes.
- O modelo recebe a pergunta mais esses trechos e é instruído a responder apenas com base neles.
- A resposta vem com a fonte, para quem lê poder confirmar.
O n8n não é o problema
O n8n continua a ser uma excelente cola para ligar sistemas. A diferença entre um assistente que inventa e um que acerta está no passo do meio: o que acontece entre a pergunta e o modelo.
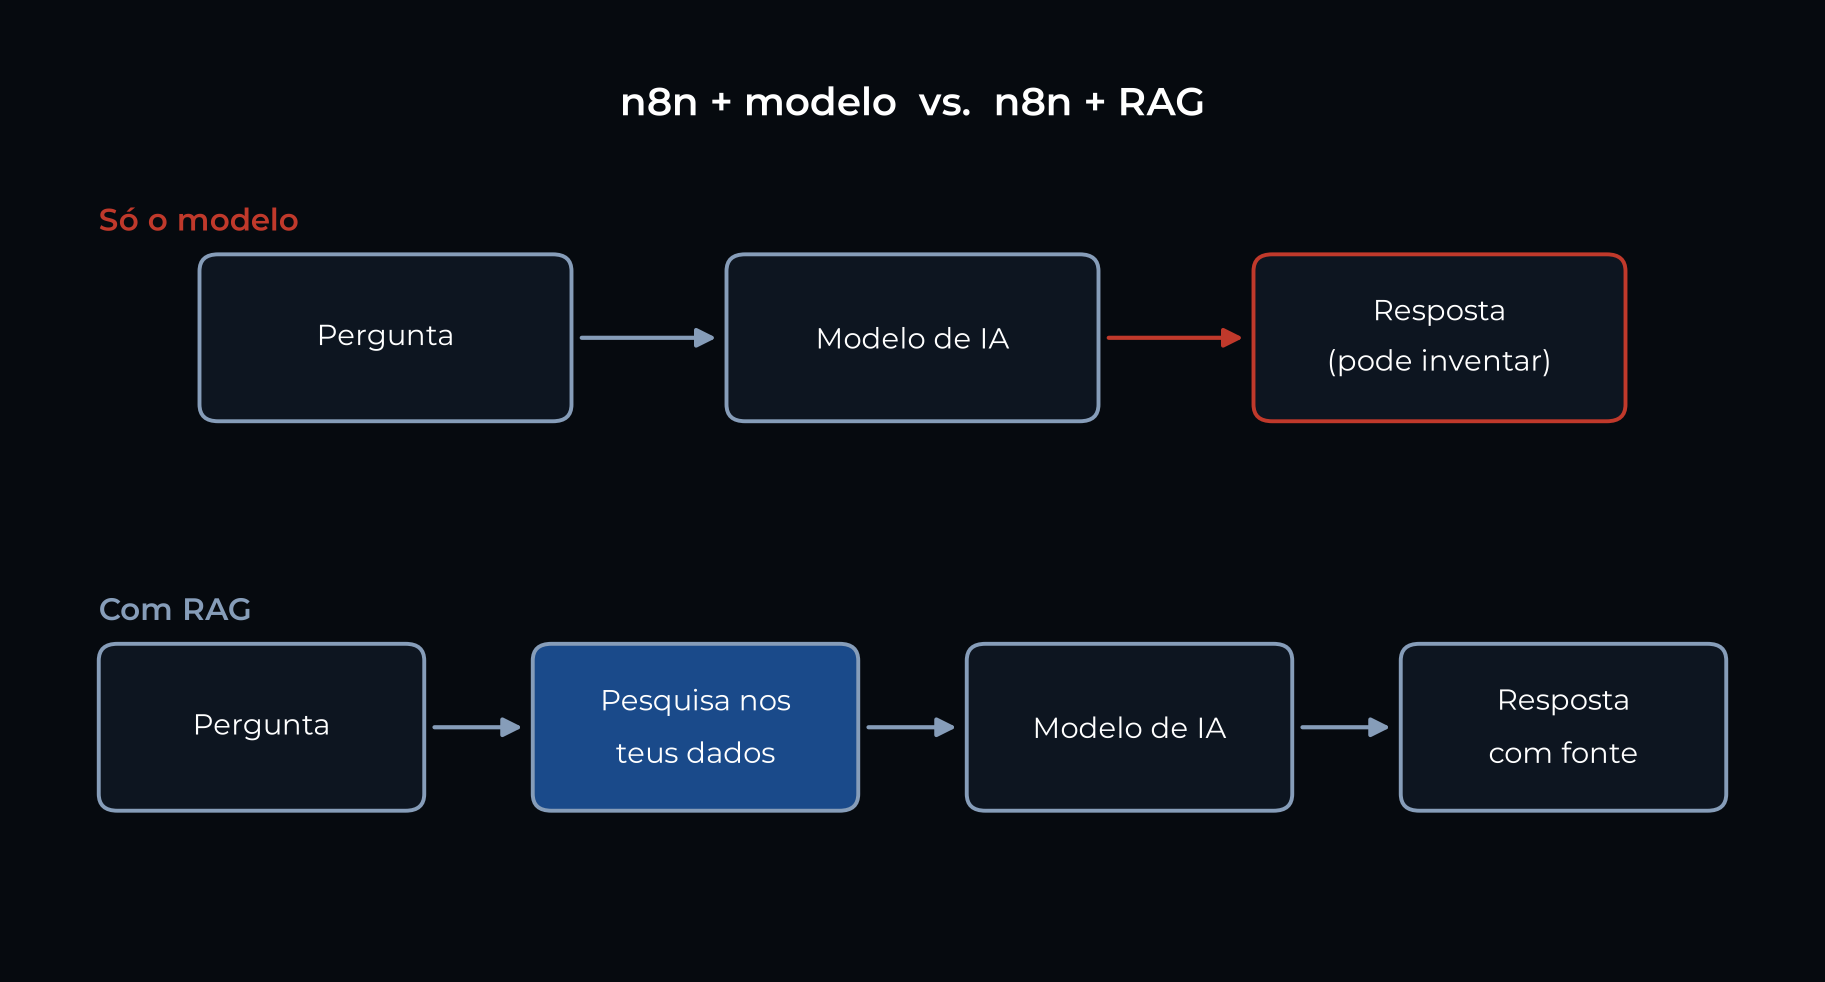
Na prática, a parte difícil nunca é chamar o modelo. É garantir que a pesquisa traz os trechos certos.
Onde o RAG se aplica (para lá do chatbot)
A ideia serve em qualquer sítio onde alguém perde tempo a procurar informação ou a responder à mesma pergunta pela décima vez. Estes são exemplos de aplicação da técnica, não casos de clientes:
| Aplicação | O RAG vai buscar a… | O que muda |
|---|---|---|
| Atendimento ao cliente | FAQ, políticas, catálogo | Respostas consistentes, com a política atual, em vez de improviso |
| Equipa interna | Procedimentos, wiki, manuais | Quem entra na equipa pergunta ao sistema em vez de interromper o colega mais sénior |
| Propostas e concursos | Propostas antigas, casos, fichas técnicas | Um primeiro rascunho a partir do que a empresa já escreveu e aprovou |
| Contratos e documentos legais | Contratos, cláusulas, políticas | Encontrar a cláusula certa em segundos. A decisão continua a ser de uma pessoa |
| Equipas técnicas | Documentação, tickets, decisões de arquitetura | Menos tempo a perguntar "porque é que isto foi feito assim?" |
| Comercial | CRM, notas de reunião, emails | Preparar uma reunião sem reler trinta emails |
Porque é que isto baixa custos
Não vou pôr aqui percentagens, porque dependem do volume e do caso. O que se pode explicar é o mecanismo:
- Menos horas a procurar e a repetir. As perguntas repetidas deixam de consumir o tempo de quem sabe a resposta.
- Menos texto enviado ao modelo por pergunta. Em vez de colar documentos inteiros no pedido, só seguem os trechos relevantes. Pagas pelo contexto que interessa.
- Um modelo mais pequeno chega, muitas vezes. Quando a resposta já está nos trechos, o modelo tem de a ler e redigir, não de a saber. Em muitos casos um modelo mais barato basta, mas isso mede-se, não se assume.
- Atualizar é trocar um documento. Mudou um preço? Muda no documento e entra no índice. Não há re-treino de modelo.
- Menos erros caros. Uma resposta errada a um cliente pode virar reembolso, reclamação ou perda de confiança. Com a fonte à vista, qualquer resposta pode ser verificada.
Onde o RAG também falha
Convém saber isto antes de investir:
- Documentos maus dão respostas más. O RAG não corrige informação desatualizada ou contraditória. Mostra-a, e muitas vezes é a primeira vez que alguém a vê.
- A pesquisa pode trazer os trechos errados. Nesse caso o modelo responde muito bem ao trecho errado, e a resposta parece convincente.
- Sem medição não sabes se funciona. É preciso um conjunto de perguntas reais, com a resposta certa conhecida, para testar antes e depois de cada alteração.
- Há RGPD. Se os documentos contêm dados pessoais, é preciso pensar em base legal, minimização (não indexar o que não é necessário), controlo de acesso (cada pessoa só deve obter o que já podia ver), onde corre o modelo, se há transferência de dados para fora da UE e durante quanto tempo se guarda o quê.
Como começar sem queimar dinheiro
- Escolhe uma pergunta que se repete muito e identifica a fonte de verdade onde está a resposta.
- Junta algumas dezenas de perguntas reais, com a resposta certa.
- Monta o mínimo e mede. Acerta? Cita a fonte? Diz "não sei" quando não sabe?
- Só depois automatiza e alarga. É aí que o n8n e as integrações entram.
Se tens documentos ou dados internos e queres perceber se o RAG faz sentido no teu caso, fala connosco. E se já tens um sistema de IA em produção que ninguém reviu, o primeiro passo é uma auditoria e correção de apps feitas com IA.